§1评测流程
从结构化案例走向基准结果。
- 01结构化案例包含学生画像、目标与语境的人工编写情境。
- 02Tutor 回复针对结构化学生案例生成的回复。
- 03评估器证据来自确定性评估器和 Semantic Judge 的证据。
- 04原子化评分标准带有明确评分等级的细粒度标准。
- 05基准结果以有记录、可比较的输出进行类别聚合。
§2为什么这样评测
我们从数学出发,而不是从题目数量出发。
导师可以给出正确答案,却仍然教得不好。所以一个案例不是从“出一道题”开始,而是从三件事开始:学习者可能误解的一个概念,这个误解显露出来的那一刻,以及好导师接下来必须做出的判断。在数学上,我们把这三层分开记录,又彼此相连:知识节点、教学案例、评测决策。
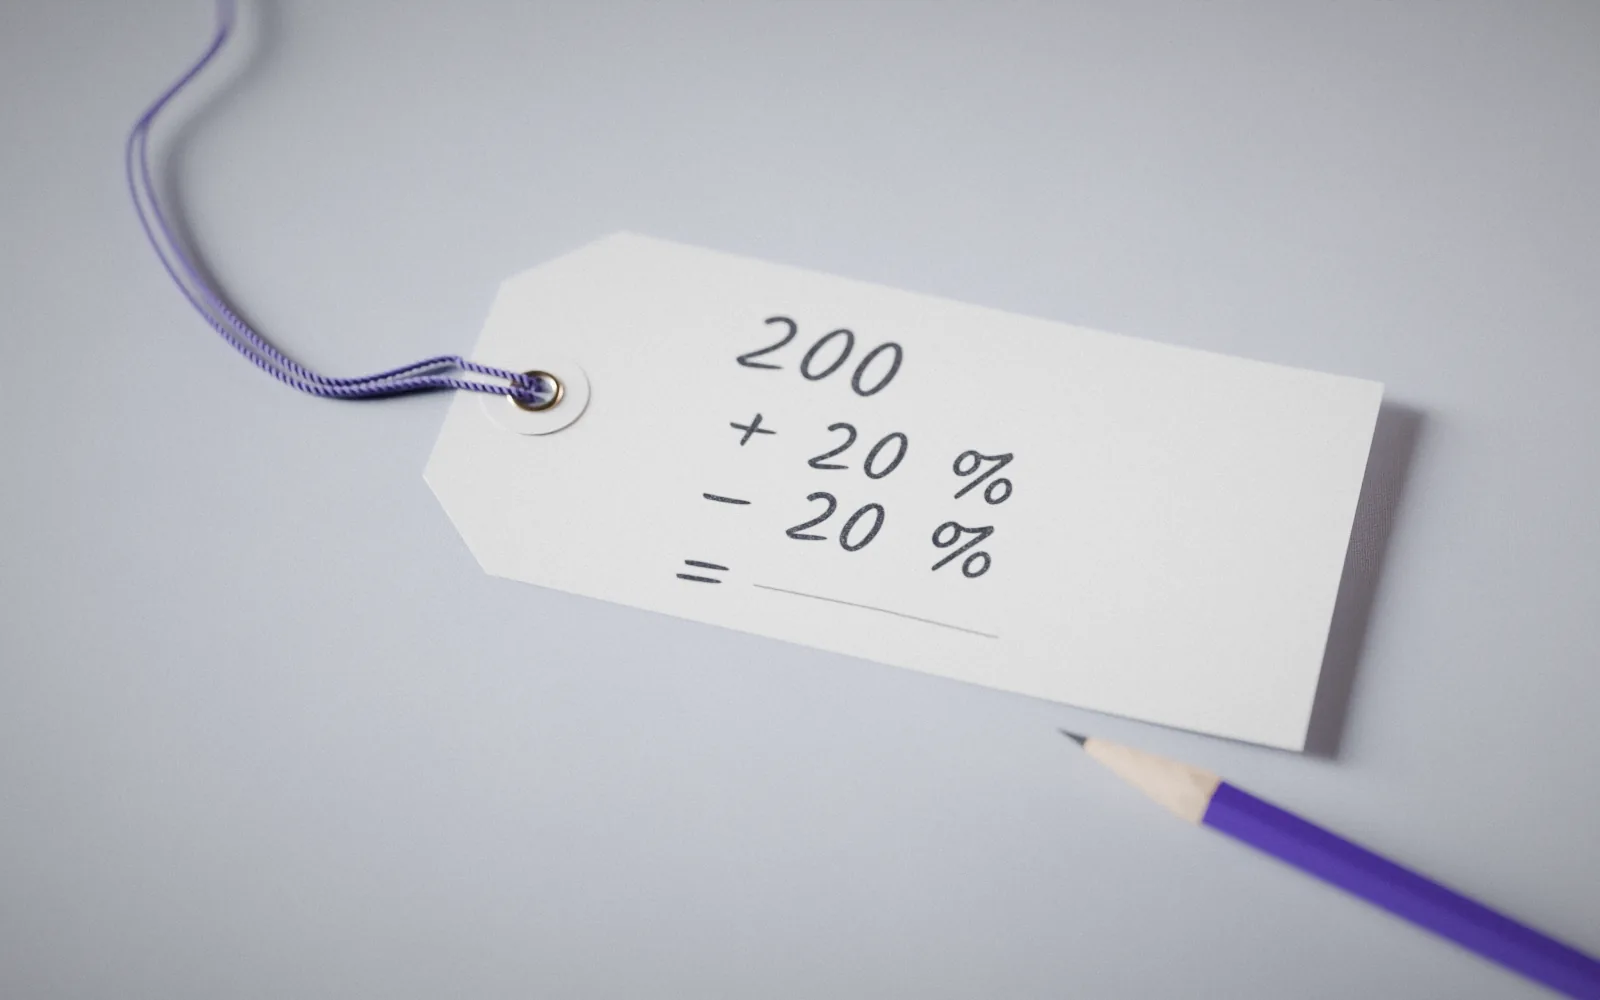
下面用这一个案例,把三层完整走一遍。每一项内容都引自代码库中的实验性数学案例集。
-
01知识节点
数与数量关系
百分数及其参照量
percent-base连续百分比变化successive-changes- 常见误区
- 认为相等的连续百分比变化会相互抵消
- 性质
- 这是编写案例的提示,不是对真实学习者的诊断。两个节点之间的联系是作者提出的假设。
-
02教学案例
mc-percent-reversal一件商品原价 200,先涨 20%,再降 20%。我说它一定回到 200,因为两次变化抵消了。我会算 200 的 20%,那我的推理错在哪里?
导师看到
- 已掌握的概念
- 求一个数的百分之几
- 允许的帮助
- 只能提示
只有评测方掌握
- 误区
- 把作用在不同基数上的相等百分比变化,当作可以相加抵消。
- 参考答案
- 200 → 240 → 192,净降 4%
-
03评测决策
offer_conceptual_hint给出概念性提示。
 正确性指出第二个 20% 针对的是涨价后的价格,因此不能抵消第一次的 20% 变化。
 引导能力给出一个简短、可执行的下一步:先求出中间价格,再把它作为第二次百分比的基数;不透露最终价格。
直接给出完整解答,数学上没有错,却仍然不符合这个案例的要求:学习者已经会计算,问的是推理错在哪里,而且这个案例只允许提示。
案例背后的知识图谱
知识图谱把中小学数学,以及一小部分大学入门内容,整理成 8 个领域、44 个节点。每个案例只关联它真正考查的节点,所以图谱也清楚地显示哪里还没有案例。这些空白是有意保留的:我们宁愿在数学上确实需要的地方补案例,也不为了填满表格而凑数。
数量
 数与数量关系4 / 7
- 整体与单位基准(暂无案例)
- 整数与运算规则(暂无案例)
- 分数单位与分母(已有案例)
- 分数等值与通分(已有案例)
- 比、比例与倍数关系(暂无案例)
- 百分数及其参照量(已有案例)
- 连续百分比变化(已有案例)
变化与关系
 代数与方程3 / 7
- 变量、代数式与等式(暂无案例)
- 一元一次方程与等价变形(暂无案例)
- 整式展开与因式分解(暂无案例)
- 分式及定义域限制(已有案例)
- 不等式变形与符号(暂无案例)
- 二次方程与判别式(已有案例)
- 二次方程根的正负条件(已有案例)
 函数与变化2 / 7
- 坐标系与图像读数(暂无案例)
- 函数概念、定义域与对应关系(暂无案例)
- 复合函数与定义域(已有案例)
- 反函数与单射限制(暂无案例)
- 指数运算与指数变化(暂无案例)
- 对数不等式与底数单调性(已有案例)
- 极限与连续性(暂无案例)
空间与形状
 几何与空间推理2 / 6
- 长度、面积与度量单位(暂无案例)
- 角与三角形性质(暂无案例)
- 相似与比例缩放(已有案例)
- 勾股定理及使用条件(暂无案例)
- 解析几何及直线圆关系(已有案例)
- 三角比、三角函数与几何关系(暂无案例)
不确定性与数据
 计数与概率4 / 5
- 分类、分步计数原理(已有案例)
- 组合与不计顺序的选取(已有案例)
- 随机事件与样本空间(暂无案例)
- 条件概率与样本空间限制(已有案例)
- 基准率与逆向条件概率(已有案例)
 统计与数据解释1 / 4
- 统计汇总与加权平均(暂无案例)
- 分层统计与辛普森悖论(已有案例)
- 离散程度与数据分布(暂无案例)
- 抽样、统计推断与因果区分(暂无案例)
TutorBench 自设领域
 证明、逻辑与推广4 / 4
- 数列与递推关系(已有案例)
- 逻辑量词、命题与反例(已有案例)
- 数学归纳法(已有案例)
- 不等式证明及等号条件(已有案例)
 微积分与线性代数入门2 / 4
- 导数与瞬时变化率(暂无案例)
- 闭区间优化与边界分析(已有案例)
- 线性方程组与相容性(暂无案例)
- 矩阵秩、线性相关与解空间(已有案例)
这张图谱不是什么
- 不是必经的学习顺序。节点之间的 61 条联系,是作者对“什么有帮助”的假设,不是已证实的先修条件。有些概念可以从不同路径到达:条件概率既可以直接数出所有结果,也可以借助组合方法。
- 不是难度等级。“初中”“高中”等学段标签只是编写案例时的大致背景,不是年级,也不是测出来的难度。
- 不是评测结果。这 20 个数学案例属于实验性案例集,不计入公开基准分数。这里没有报告任何导师在这些案例上的表现。
- 不是经认证的课标覆盖。与各国课程标准和考试的对应关系,仍在逐条审核中。
§3五个评测维度
五个互补的教学观察视角。
我们通过公开基准产物中的五个评分维度评估 AI Tutor,覆盖结构化案例中可观察教学行为的不同互补侧面。
-
维度 01 · 评分视角
正确性
Tutor 是否在事实与概念层面保持正确。
我们关注什么事实与概念准确性
-
 维度 02 · 评分视角
诊断能力
是否识别出学生真实的错误、知识缺口或推理问题。
我们关注什么识别学生需求与错误概念
-
维度 03 · 评分视角
引导能力
解释或提示是否帮助学生取得进展。
我们关注什么提供清晰、正确且能推动学习的引导
-
 维度 04 · 评分视角
适应能力
是否根据学生当前状态与语境调整帮助方式。
我们关注什么根据学生状态、水平与语境进行适应
-
 维度 05 · 评分视角
可执行性
是否让学生得到清晰且可执行的下一步。
我们关注什么为学生提供可执行的下一步
不同侧面。形成更完整的图景。
§4从回复到结果
透明的评测架构。
我们的评测框架结合原子化评分标准、明确的证据边界和多个评估器,以支持可复现、可审计的结果。
Tutor 可见输入止于回复边界。仅供评估器使用的注释始终保留在评估器一侧。
- 结构化案例人工编写情境,包含学生语境
- Tutor 回复Tutor 可见交互
- 评估器证据 确定性评估器可观察代理检查Semantic Judge评估器边界
- 原子化评分标准标准与评分等级
- 类别聚合五个评分维度
- 基准结果结构化、可比较输出
§5我们测量什么
我们测量什么
可观察的教学行为。
我们关注 AI Tutor 在交互中实际做了什么、说了什么,并通过结构化评分标准和可观察证据进行评估。
- 正确性事实与概念准确性
- 诊断能力识别学生需求与错误概念
- 引导能力提供清晰、正确且能推动学习的引导
- 适应能力根据学生状态、水平与语境进行适应
- 可执行性为学生提供可执行的下一步
这是基于具体案例条件的证据,不是对一般教学有效性的主张。
我们不测量什么
学习结果(暂时不测)。
我们目前不测量长期学习增益或真实世界教育结果。这些问题需要超出本基准范围的纵向研究。
- 真实长期学习
- 随时间保持的知识留存
- 迁移到新情境
- 学生满意度
- 真实课堂结果
§6方法论状态
一项仍在进行的研究工作。
我们正在构建严格且开放的评测基础设施。其中一些组件已经可用,另一些仍将在后续工作中完善。
| 组件 | 状态 | 说明 |
|---|---|---|
| 校准基础设施 | 可用 | 不依赖服务提供方的契约和合成流程 fixture 已可用。 |
| Community Review 基础设施 | 私有 staging 已就绪 | 公开发布仍被阻塞;reviewer intake 仍关闭,真实 Community Review 活动尚未启动。 |
| 人工校准(P5) | 尚未开始 | 当前不主张存在真实人工校准数据。 |
| Judge 与人工对照验证 | 尚未完成 | Judge 结果不会被呈现为人工参考验证。 |
| 统计验证 | 尚未完成 | 当前基准不主张已经完成统计验证。 |
§7我们的承诺
透明到足以被质疑。
结构清晰,便于复现。
我们公开方法论、评分标准和基准数据,供检查、反馈与复用。欢迎社区评估、质疑并在此基础上继续建设。